 Hotline: 0846 599 665


File robots.txt là một tệp văn bản đặt tại thư mục gốc của website, hướng dẫn bot tìm kiếm biết phần nào được phép thu thập dữ liệu và phần nào không. Nghe đơn giản, nhưng đây là một trong những file có sức ảnh hưởng lớn nhất đến SEO kỹ thuật.
Bài viết này được chia làm hai tầng. Nếu bạn mới làm SEO, đọc đến hết section 4 là đủ kiến thức nền. Nếu bạn là SEO Manager hoặc đang quản lý dự án nhiều URL, các section từ 5 đến 10 sẽ đi sâu vào template thực chiến, AI crawler 2026, troubleshooting và crawl budget.
File robots.txt là gì?
File robots.txt là một tệp văn bản đơn giản đặt tại thư mục gốc của website, có nhiệm vụ hướng dẫn các trình thu thập dữ liệu (bot) của công cụ tìm kiếm biết được phần nào của site được phép crawl và phần nào không. Đây là một thành phần của Robots Exclusion Protocol (REP) – bộ tiêu chuẩn web ra đời từ năm 1994 và đến nay vẫn được Google, Bing, Yandex cùng hầu hết bot hợp lệ tuân thủ.
Trong thực tế triển khai dự án, file này phục vụ ba mục đích chính:
- Quản lý lưu lượng crawl: giảm tải cho server khi bot truy cập quá nhiều, đặc biệt với website e-commerce hoặc news site có hàng chục nghìn URL.
- Định hướng crawl: chỉ ra cho bot biết nhóm URL nào không có giá trị SEO để bỏ qua, dành crawl budget cho các trang quan trọng.
- Công bố vị trí Sitemap giúp bot phát hiện Sitemap XML nhanh hơn mà không cần phụ thuộc hoàn toàn vào Search Console.
Cảnh báo quan trọng cần nắm trước khi đi xa hơn
Đây là hiểu lầm phổ biến nhất khiến nhiều dự án SEO mất traffic: robots.txt không phải công cụ để ẩn một trang khỏi kết quả tìm kiếm Google. Khi bạn Disallow một URL, Googlebot sẽ không truy cập vào trang đó nữa – nhưng nếu URL này được liên kết từ nơi khác trên web, Google vẫn có thể index địa chỉ URL và hiển thị nó trong SERP, chỉ không có mô tả nội dung.
Muốn thật sự ẩn một trang khỏi index, bạn cần dùng thẻ meta noindex hoặc bảo vệ bằng mật khẩu – không phải robots.txt. Sự khác biệt này sẽ được làm rõ ở bảng phân biệt 4 phương pháp trong section 4.
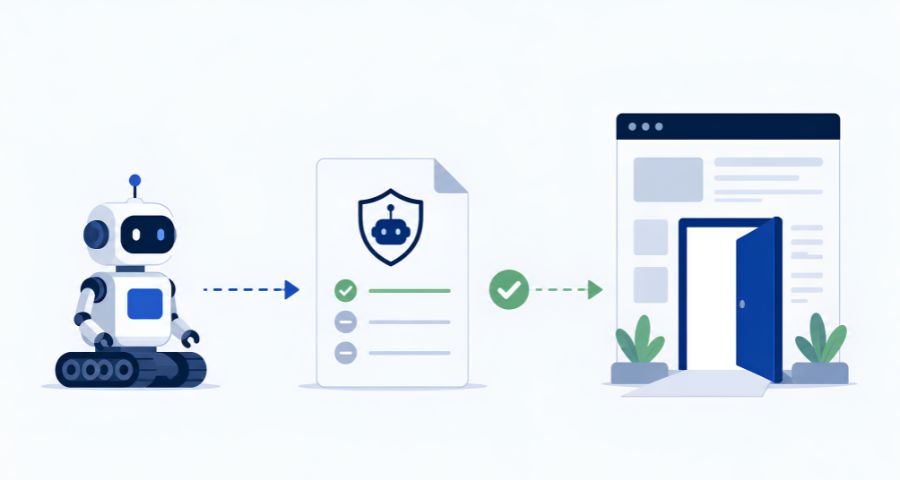
Sơ đồ khái niệm file robots.txt hoạt động như cổng kiểm soát giữa bot tìm kiếm và website
Robots.txt hoạt động ra sao trong quy trình Crawl–Index của Google?
Để dùng robots.txt đúng, cần hiểu trước nó nằm ở đâu trong vòng đời của một URL trên Google. Quy trình chuẩn gồm ba giai đoạn: Crawl (thu thập dữ liệu) → Index (lập chỉ mục) → Rank (xếp hạng). robots.txt chỉ tác động ở giai đoạn đầu tiên.
Mỗi lần Googlebot chuẩn bị truy cập một domain, nó sẽ kiểm tra file robots.txt trước. Nếu URL được phép, bot tiếp tục tải nội dung. Nếu URL bị Disallow, bot dừng lại và không lấy về HTML của trang. Đây là lý do robots.txt được gọi là “gating step” – cửa kiểm soát trước khi crawl diễn ra. Quy trình chi tiết được Google mô tả trong tài liệu chính thức về robots.txt của Google Search Central.
Khi nào Googlebot đọc lại robots.txt
Google không đọc file robots.txt mỗi lần crawl một URL. Thay vào đó, Googlebot cache file này và refresh định kỳ – thường khoảng 24 giờ một lần đối với site có tần suất crawl bình thường. Điều này có nghĩa là nếu bạn vừa cập nhật robots.txt, Google chưa nhận thay đổi ngay. Muốn đẩy nhanh, có thể dùng tính năng “Request a recrawl” trong Search Console.
Điều gì xảy ra nếu robots.txt trả về lỗi
Hành vi của Googlebot khác nhau theo mã trạng thái HTTP mà server trả về:
- 404 Not Found: Google coi như không có robots.txt và crawl toàn bộ site như bình thường.
- 5xx Server Error trong thời gian ngắn: Google tạm dừng crawl, đợi file hồi phục rồi tiếp tục.
- 5xx kéo dài trên 30 ngày: Google fallback về phiên bản robots.txt được cache trước đó, hoặc coi như không có file.
Đây là lý do file robots.txt phải có uptime cao như một trang quan trọng. Nếu server thường xuyên trả về 503, crawl budget của site bị ảnh hưởng nghiêm trọng.
Tại sao URL bị Disallow vẫn có thể xuất hiện trên Google
Khi một URL bị chặn nhưng có backlink từ trang khác trỏ tới, Google biết URL đó tồn tại nhưng không biết nội dung bên trong. Kết quả là URL này có thể xuất hiện trên SERP dưới dạng “URL-only listing” – chỉ hiện địa chỉ trang, không có tiêu đề và mô tả. Đây là dạng kết quả gây hiểu nhầm phổ biến mà nhiều SEOer mới cho rằng “robots.txt không hoạt động”.
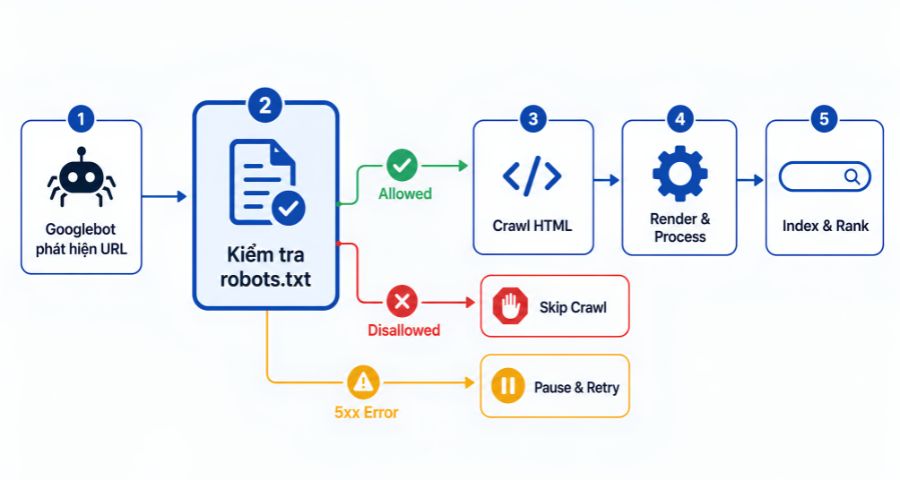
Sơ đồ quy trình robots.txt trong pipeline Crawl, Render, Index, Rank của Google
File robots.txt là gì? Cái nhìn tổng quan về SEO với robots.txt
Cú pháp file robots.txt – Toàn bộ directive cần biết
Hầu hết tài liệu tiếng Việt chỉ đề cập đến 5 directive cơ bản. Trên thực tế, để viết robots.txt chính xác cho dự án phức tạp, bạn cần nắm thêm pattern matching và biết directive nào đã deprecated. Chi tiết kỹ thuật đầy đủ có trong Robots.txt Specification của Google.
5 directive cốt lõi
User-agent xác định bot nào nhận quy tắc bên dưới. Dùng * để áp dụng cho mọi bot, hoặc tên cụ thể như Googlebot, Bingbot, GPTBot. Một file có thể chứa nhiều khối User-agent, mỗi khối với bộ rule riêng.
Disallow chặn bot crawl một đường dẫn. Cú pháp Disallow: /admin/ chặn toàn bộ thư mục admin. Cú pháp Disallow: / chặn toàn site – chính là dòng lệnh nguy hiểm nhất nếu đặt sai. Lưu ý: path trong Disallow phân biệt chữ hoa chữ thường, /Admin/ và /admin/ là hai đường dẫn khác nhau với Google.
Allow ghi đè Disallow cho một đường dẫn con. Ví dụ: chặn cả thư mục /wp-admin/, nhưng vẫn cho phép /wp-admin/admin-ajax.php hoạt động bằng cách thêm dòng Allow: /wp-admin/admin-ajax.php ngay sau Disallow.
Crawl-delay yêu cầu bot đợi vài giây giữa các request. Google đã không hỗ trợ directive này từ lâu. Nếu cần giảm tốc độ crawl của Googlebot, dùng “Crawl rate settings” trong Search Console hoặc trả về mã 503 tạm thời với header Retry-After. Bing và Yandex vẫn tuân thủ Crawl-delay.
Sitemap khai báo vị trí sitemap XML, dùng URL tuyệt đối: Sitemap: https://yourdomain.com/sitemap.xml. Đây là directive độc lập, không cần đặt dưới User-agent nào, và có thể khai báo nhiều dòng Sitemap nếu site có nhiều file.
Pattern matching: wildcard và end-of-URL
Đây là phần đối thủ Việt thường bỏ qua. Google hỗ trợ hai ký tự đặc biệt giúp viết rule linh hoạt hơn:
- Dấu * đại diện cho bất kỳ chuỗi ký tự nào. Ví dụ Disallow: /*?sort= chặn mọi URL có tham số sort, bất kể trang nào.
- Dấu $ đánh dấu kết thúc URL. Ví dụ Disallow: /*.pdf$ chặn mọi URL kết thúc bằng .pdf nhưng không chặn .pdf?download=1.
Hai pattern này cực kỳ hữu ích cho website e-commerce có nhiều URL filter và tracking parameter.
Directive đã deprecated cần tránh
Google từng hỗ trợ directive Noindex trong robots.txt nhưng đã chính thức ngừng từ tháng 9/2019. Nếu bạn đang dùng Noindex trong file robots.txt, cần chuyển sang thẻ meta noindex hoặc HTTP header X-Robots-Tag ngay lập tức.
| Directive | Googlebot | Bingbot | Yandex | AI bots |
| User-agent | ✓ | ✓ | ✓ | ✓ |
| Disallow | ✓ | ✓ | ✓ | ✓ (đa số) |
| Allow | ✓ | ✓ | ✓ | Tùy bot |
| Crawl-delay | ✗ | ✓ | ✓ | Tùy bot |
| Sitemap | ✓ | ✓ | ✓ | Không liên quan |
| Wildcard * | ✓ | ✓ | ✓ | Tùy bot |
| End $ | ✓ | ✓ | ✓ | Tùy bot |
Phân biệt robots.txt với noindex, canonical và mật khẩu – Dùng cái nào khi nào?
Đây là section có giá trị clarify cao nhất. Trong audit của HEROSEO, rất nhiều SEOer in-house vẫn dùng sai 4 phương pháp này, dẫn đến hai hậu quả: trang đáng index thì bị chặn, trang cần ẩn thì vẫn lộ.
Bốn phương pháp này phục vụ bốn mục tiêu khác nhau:
- robots.txt Disallow kiểm soát hành vi crawl. Bot không vào trang, không tốn crawl budget. Nhưng URL vẫn có thể xuất hiện trên SERP nếu có backlink.
- Meta noindex kiểm soát hành vi index. Bot vẫn vào trang và đọc nội dung, nhưng không thêm vào chỉ mục Google. Đây là cách đúng để ẩn trang khỏi kết quả tìm kiếm.
- Canonical tag gộp tín hiệu xếp hạng từ nhiều URL trùng về một URL chính. Không chặn crawl, không chặn index, chỉ điều phối tín hiệu.
- Mật khẩu/authentication bảo vệ thật sự ở cấp server. Bot không vào được, người dùng không có quyền cũng không vào được.
Cảnh báo: kết hợp sai làm vô hiệu cả hai
Trường hợp gặp nhiều nhất trong audit: dev thêm cả Disallow trong robots.txt và noindex trong meta tag cho cùng một URL, với ý nghĩ “chặn cho chắc”. Kết quả ngược lại với mong đợi.
Khi URL bị Disallow, Googlebot không vào trang. Bot không vào trang thì không đọc được meta noindex. Hệ quả: URL vẫn có thể được index dưới dạng URL-only listing, đúng tình huống bạn muốn tránh.
Nguyên tắc đúng: nếu mục tiêu là ẩn trang khỏi SERP, dùng noindex đơn lẻ và để robots.txt cho phép crawl bình thường.
| Tình huống | robots.txt Disallow | Meta noindex | Canonical | Mật khẩu |
| Ẩn trang khỏi SERP | ✗ | ✓ | ✗ | ✓ |
| Tiết kiệm crawl budget | ✓ | ✗ | △ | ✗ |
| Gộp URL trùng lặp | ✗ | ✗ | ✓ | ✗ |
| Bảo mật dữ liệu nhạy cảm | ✗ | ✗ | ✗ | ✓ |
Để hiểu sâu hơn về cách kết hợp noindex và canonical trong dự án thực tế, có thể tham khảo bài “noindex meta tag là gì” và “canonical URL trong SEO trong cùng cluster Technical SEO” của HEROSEO.
Các tệp đặc biệt trong robots.txt
7 template robots.txt thực chiến theo loại website
Một file robots.txt tốt phải phù hợp với kiến trúc URL của từng loại website. Dưới đây là 7 template được HEROSEO sử dụng làm điểm khởi đầu cho các dự án thực tế. Mỗi template cần được điều chỉnh thêm dựa trên cấu trúc URL cụ thể của site.
Template 1 – WordPress blog cá nhân hoặc doanh nghiệp
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/
Sitemap: https://yourdomain.com/sitemap_index.xml
Chặn khu vực quản trị nhưng cho phép admin-ajax.php vì WordPress dùng file này cho nhiều tính năng frontend. Chặn URL kết quả search nội bộ để tránh tạo trang mỏng.
Template 2 – WooCommerce / Shopify e-commerce
User-agent: *
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /*?orderby=
Disallow: /*?filter_
Disallow: /*?add-to-cart=
Sitemap: https://yourdomain.com/sitemap.xml
Chặn các URL giao dịch không có giá trị SEO và các URL filter sinh ra hàng nghìn biến thể trùng lặp. Đây là nhóm URL ngốn crawl budget nặng nhất ở e-commerce.
Template 3 – Website có hệ thống search & filter
User-agent: *
Disallow: /*?sort=
Disallow: /*?page=
Disallow: /*?utm_
Disallow: /search?
Allow: /search$
Sitemap: https://yourdomain.com/sitemap.xml
Pattern /*?utm_ chặn mọi URL có tracking parameter UTM, giúp ngăn Google index nhầm URL có UTM thay vì URL gốc.
Template 4 – News / Magazine site
User-agent: *
Disallow: /admin/
Disallow: /author/*/page/
Disallow: /tag/*/page/
Disallow: /*?print=
Sitemap: https://yourdomain.com/sitemap-news.xml
Sitemap: https://yourdomain.com/sitemap-articles.xml
News site thường có nhiều URL phân trang theo tác giả và tag. Chặn các trang phân trang sâu để giữ index cho bài viết chính. Khai báo cả sitemap news và sitemap articles riêng.
Template 5 – SaaS multi-language
User-agent: *
Disallow: /app/
Disallow: /dashboard/
Disallow: /api/
Disallow: /*?locale=
Sitemap: https://yourdomain.com/sitemap-en.xml
Sitemap: https://yourdomain.com/sitemap-vi.xml
Sitemap: https://yourdomain.com/sitemap-id.xml
Chặn khu vực ứng dụng đăng nhập và API endpoint. Khai báo sitemap riêng theo ngôn ngữ để hỗ trợ Google hiểu cấu trúc hreflang.
Template 6 – Landing page đơn lẻ
User-agent: *
Allow: /
Sitemap: https://yourdomain.com/sitemap.xml
Landing page thường chỉ vài URL nên không cần chặn nhiều. Allow root để rõ ràng intent, khai báo sitemap để Google index nhanh.
Template 7 – Website giai đoạn dev / staging
User-agent: *
Disallow: /
Chặn toàn bộ với staging site. Nhưng cẩn trọng: file này tuyệt đối không được deploy lên production. Trong audit của HEROSEO, đây là lỗi xảy ra nhiều nhất khi team dev quên đổi robots.txt khi go-live, dẫn đến mất toàn bộ ranking.
Để rà soát tổng thể tình trạng robots.txt và các yếu tố Technical SEO khác trên website của bạn, dịch vụ Technical SEO Audit của HEROSEO có quy trình kiểm tra chi tiết theo từng nhóm rủi ro ưu tiên.
Hướng dẫn tạo file robots.txt – 3 cách phổ biến
Trước khi tạo, hãy kiểm tra website đã có robots.txt chưa bằng cách truy cập https://yourdomain.com/robots.txt. Nếu hiện nội dung, file đã tồn tại. Nếu trả về 404, bạn cần tạo mới.
Cách 1: Plugin SEO cho WordPress
Yoast SEO, Rank Math, và All in One SEO đều có tính năng chỉnh sửa robots.txt trực tiếp từ dashboard. Đường dẫn quen thuộc với Yoast: SEO → Tools → File editor. Plugin sẽ tự tạo file ảo nếu chưa có, hoặc cho phép sửa file vật lý nếu đã tồn tại.
Ưu điểm là không cần đụng đến server. Nhược điểm là phụ thuộc vào plugin – khi plugin lỗi hoặc bị disable, file robots.txt có thể quay về mặc định.
Cách 2: Upload thủ công qua FTP hoặc File Manager
Đây là cách HEROSEO khuyến nghị cho website có team dev riêng. Tạo file robots.txt bằng Notepad hoặc bất kỳ text editor nào, upload vào thư mục gốc của domain (thường là public_html hoặc www).
Cách này cho kiểm soát hoàn toàn, không phụ thuộc CMS hay plugin, và phù hợp với CI/CD pipeline khi muốn version control file robots.txt cùng codebase.
Cách 3: Tạo qua hosting control panel
cPanel, DirectAdmin và các control panel khác đều có File Manager cho phép tạo file trực tiếp trong trình duyệt. Phù hợp cho người không quen FTP nhưng vẫn muốn tự xử lý.
Lưu ý cho CMS không hỗ trợ trực tiếp
Wix, Squarespace, Blogger và một số nền tảng SaaS không cho phép chỉnh sửa file robots.txt thủ công. Thay vào đó, các platform này có giao diện riêng để cấu hình rule crawl. Tìm trong settings với từ khóa “search engine visibility” hoặc “indexing”.
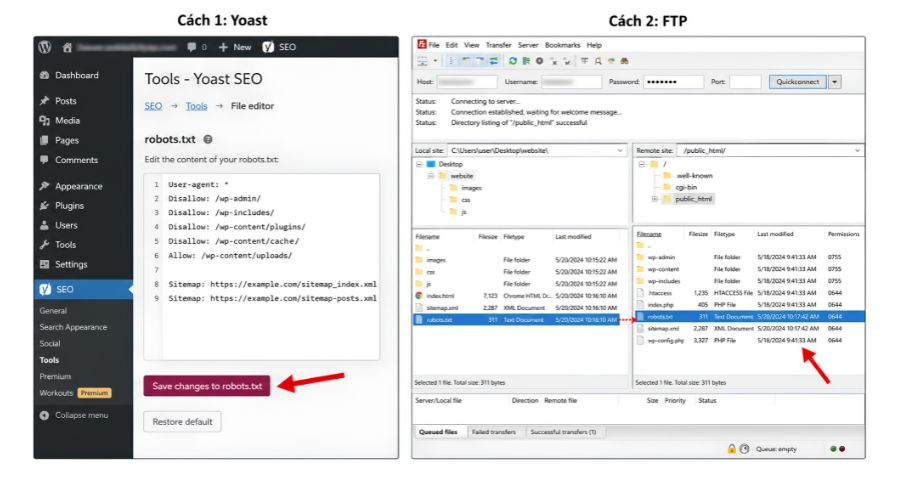
Hướng dẫn 3 cách tạo file robot.txt dễ thực hiện
Robots.txt cho AI crawler – Có nên chặn GPTBot, ClaudeBot, Google-Extended?
Đây là câu hỏi mà ngay cả nhiều SEO Manager kỳ cựu cũng đang tìm câu trả lời. Năm 2026, ngoài bot công cụ tìm kiếm truyền thống, website của bạn còn được truy cập bởi một lớp bot mới: AI crawler, dùng để huấn luyện và phục vụ các mô hình AI như ChatGPT, Claude, Gemini, Perplexity.
Khác với Googlebot – crawl để index cho Google Search – AI crawler crawl để học hỏi nội dung phục vụ AI training, hoặc để truy xuất real-time khi user hỏi AI một câu cần dẫn nguồn từ web.
Bảng AI crawler 2026 cần biết
Tính tới T5/2026, các AI crawler phổ biến nhất gồm:
- GPTBot (OpenAI): dùng để training mô hình GPT. Có thể chặn riêng mà không ảnh hưởng đến OAI-SearchBot phục vụ ChatGPT Search.
- ClaudeBot (Anthropic): thu thập dữ liệu cho Claude và Claude Search.
- CCBot (Common Crawl): crawl dữ liệu công khai cho dataset Common Crawl – nguồn được nhiều mô hình AI sử dụng.
- Google-Extended: không phải crawler riêng, mà là token cho phép kiểm soát việc Google dùng nội dung site cho training Gemini và Vertex AI, tách biệt với Googlebot phục vụ Search.
- PerplexityBot: crawl cho Perplexity AI Search.
- Applebot-Extended: kiểm soát việc Apple dùng nội dung cho Apple Intelligence.
Ba chiến lược chính
Chiến lược 1 – Cho phép tất cả AI crawler. Phù hợp với brand muốn xuất hiện trong AI Search và chấp nhận content được dùng cho training.
Chiến lược 2 – Chặn toàn bộ AI crawler. Phù hợp với content premium, paywall, dữ liệu nghiên cứu độc quyền hoặc khi pháp lý yêu cầu.
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: CCBot
Disallow: /
User-agent: Google-Extended
Disallow: /
User-agent: PerplexityBot
Disallow: /
Chiến lược 3 – Chặn chọn lọc. Cho phép bot crawl phục vụ AI Search real-time (để vẫn xuất hiện trong câu trả lời AI có dẫn nguồn), nhưng chặn bot dùng cho training. Cách này khó duy trì vì các công ty AI thay đổi cấu trúc bot khá nhanh, cần review định kỳ.
Trade-off cần cân nhắc
Chặn AI crawler không ảnh hưởng đến ranking trên Google Search. Nhưng có thể ảnh hưởng đến khả năng nội dung được trích dẫn trong ChatGPT, Claude, Perplexity khi user hỏi về thương hiệu hoặc lĩnh vực của bạn. Với các brand muốn xây dựng AI Search visibility, đây là yếu tố cần đưa vào chiến lược SEO tổng thể, không chỉ là quyết định kỹ thuật đơn lẻ.
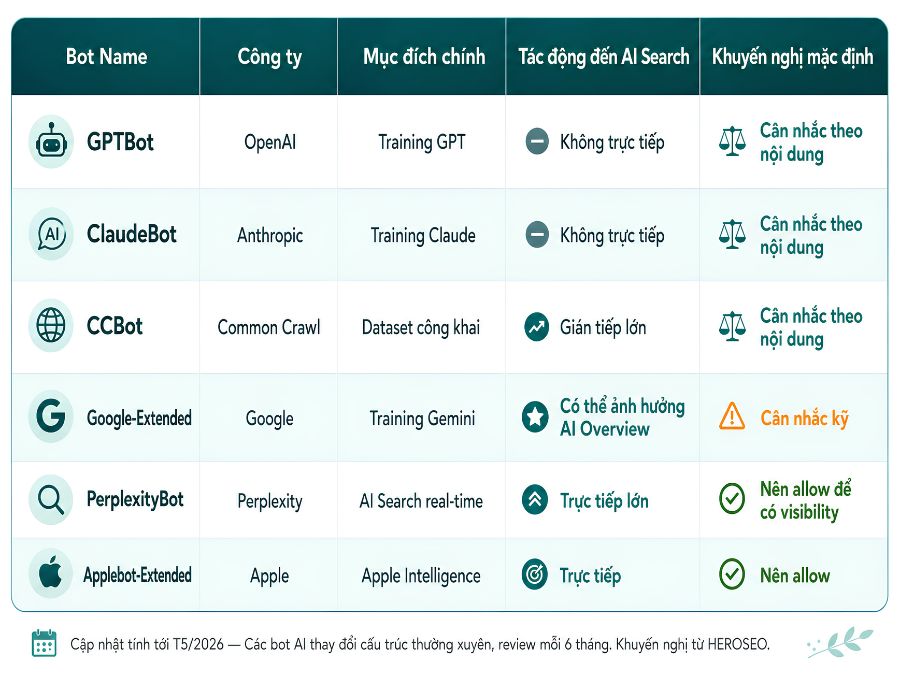
Bảng AI Crawler 2026 và khuyến nghị từ HEROSEO
8 lỗi robots.txt thường gặp khiến website mất traffic
Đây là tổng hợp các lỗi HEROSEO thường phát hiện trong audit Technical SEO, sắp xếp theo mức độ nghiêm trọng giảm dần.
Lỗi 1: Disallow nhầm thư mục chính
Một dòng Disallow: / chặn toàn bộ website. Lỗi này thường xảy ra khi dev copy file từ staging sang production mà quên sửa. Hậu quả: Google ngừng crawl toàn site, ranking tụt dần trong vài tuần.
Cách phát hiện: Truy cập trực tiếp yourdomain.com/robots.txt và check dòng đầu. Cách sửa: Đổi thành Disallow: (để trống) hoặc xóa dòng, sau đó submit robots.txt mới trong Search Console.
Lỗi 2: Chặn CSS và JS
Một số file robots.txt cũ chặn /wp-includes/ hoặc /assets/js/. Google cần các file này để render trang đúng cách. Nếu chặn, Googlebot có thể đánh giá trang như “broken layout”, ảnh hưởng đến Mobile-Friendly và Core Web Vitals.
Cách sửa: Xóa Disallow cho thư mục chứa CSS/JS, dùng “URL Inspection” trong Search Console để verify Google render đúng.
Lỗi 3: Robots.txt trả về 5xx kéo dài
Khi server trả về lỗi 503 hoặc 500 cho file robots.txt trong nhiều ngày, Google tạm dừng crawl toàn bộ site. Đây là một trong những nguyên nhân ít được chú ý nhất gây tụt traffic.
Cách phát hiện: Theo dõi log server hoặc dùng SEOReporter để monitor uptime của robots.txt. Cách sửa: Đảm bảo file robots.txt có uptime tương đương với trang chủ.
Lỗi 4: Đặt sai vị trí
Robots.txt phải đặt ở root domain: https://yourdomain.com/robots.txt. Đặt ở /blog/robots.txt hay subdirectory khác sẽ không có tác dụng. Mỗi subdomain cần file robots.txt riêng.
Lỗi 5: Disallow + noindex cùng lúc
Như đã phân tích ở section 4, kết hợp này làm noindex mất tác dụng. URL vẫn có thể xuất hiện trên SERP dưới dạng URL-only listing.
Cách sửa: Chọn một trong hai phương pháp dựa trên mục tiêu. Nếu muốn ẩn trang khỏi index, dùng noindex và để robots.txt cho phép crawl.
Lỗi 6: Sai case trong path
Path trong Disallow phân biệt chữ hoa chữ thường. Disallow: /Admin/ không chặn /admin/. Lỗi này thường xảy ra với website có URL không chuẩn hóa case.
Lỗi 7: Chặn /wp-content/uploads/
Một số guide cũ khuyên chặn toàn bộ /wp-content/. Hệ quả: ảnh trên site không được Google index, mất traffic từ Image Search. Với website e-commerce và blog có nhiều ảnh, đây có thể là tổn thất đáng kể.
Cách sửa: Cho phép /wp-content/uploads/ được crawl bình thường, chỉ chặn các thư mục thực sự nhạy cảm.
Lỗi 8: Quên cập nhật khi đổi cấu trúc URL
Sau khi migrate website hoặc đổi URL structure, file robots.txt cũ vẫn giữ các rule cho URL cũ – dẫn đến chặn nhầm URL mới hoặc bỏ sót URL cần chặn.
Cách sửa: Đưa robots.txt vào checklist migration. Mỗi lần đổi URL structure, review lại từng dòng Disallow xem còn đúng không.
Trong các dự án Technical SEO Audit, HEROSEO thường thấy 1–2 trong 8 lỗi trên xuất hiện trên cùng một website, đặc biệt sau khi website trải qua migration hoặc đổi team dev. Vì vậy, nếu bạn vừa thực hiện thay đổi lớn về cấu trúc, hãy rà soát lại file robots.txt trước khi bỏ qua các cảnh báo trong Search Console.
Cách kiểm tra & debug robots.txt với Search Console
Sau khi tạo hoặc cập nhật file robots.txt, không nên chỉ tin vào lý thuyết – cần verify thực tế Google đã nhận và xử lý đúng chưa.
Robots.txt report trong Search Console
Google đã thay thế robots.txt Tester cũ bằng robots.txt report trong Search Console phiên bản mới. Đường dẫn: Settings → robots.txt. Báo cáo này cho thấy:
- Version của robots.txt Google đang dùng
- Thời điểm Google fetch lần cuối
- Lỗi cú pháp nếu có
- Số lượng dòng và byte size
Nếu có cảnh báo, click vào dòng cụ thể để xem chi tiết. Tài liệu chính thức về tool này có tại Google Search Central – Submit updated robots.txt.
Buộc Google cập nhật robots.txt nhanh
Mặc định, Google cache robots.txt khoảng 24 giờ. Muốn ép cập nhật ngay sau khi sửa, vào robots.txt report và bấm Request a recrawl. Google sẽ ưu tiên fetch lại file trong vòng vài phút đến vài giờ.
Test rule cụ thể trước khi deploy
Trước khi áp dụng rule mới, hãy mô phỏng test bằng cách paste URL cần kiểm tra vào URL Inspection Tool. Báo cáo sẽ cho biết URL có bị chặn bởi robots.txt hay không, và bị chặn bởi dòng nào.
Đọc log server để xác nhận hành vi bot
Với dự án quan trọng, không chỉ tin vào Search Console mà còn kiểm tra log server xem Googlebot có thật sự tuân thủ rule không. Lọc log theo User-agent Googlebot và check xem có request nào tới URL đã Disallow không.
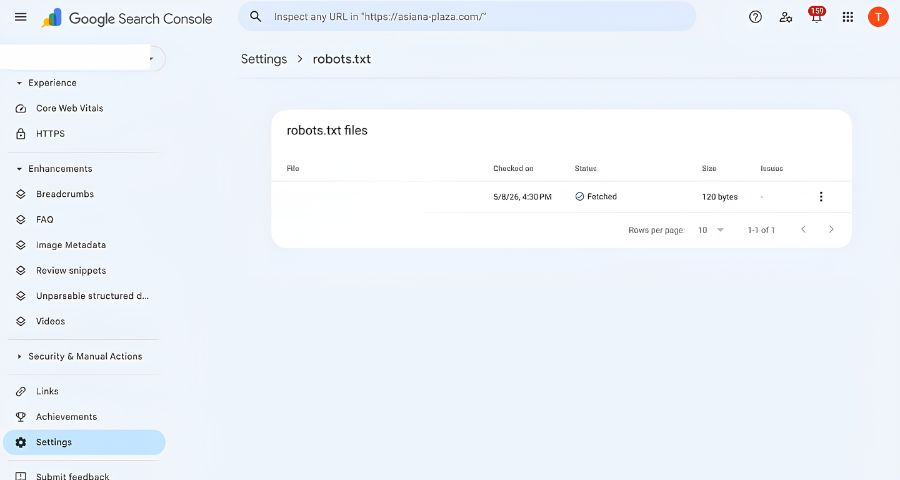
Báo cáo robots.txt trong Google Search Console của dự án thực tế HEROSEO triển khai
Robots.txt trong chiến lược crawl budget cho website lớn
Với website dưới 1.000 URL, crawl budget gần như không phải vấn đề. Nhưng với e-commerce 10.000+ SKU, marketplace, hoặc news site có hàng chục nghìn bài, robots.txt trở thành một trong những công cụ quan trọng nhất để kiểm soát ngân sách crawl.
Crawl budget là gì và dấu hiệu website đang lãng phí
Crawl budget là số lượng URL Googlebot sẵn sàng crawl trên site của bạn trong một khoảng thời gian. Khi crawl budget bị tiêu vào các URL không có giá trị, các URL quan trọng bị crawl chậm hoặc bị bỏ qua.
Dấu hiệu nhận biết website đang lãng phí crawl budget:
- URL mới publish mất nhiều tuần mới được index
- Search Console báo “Discovered – currently not indexed” tăng dần
- Crawl Stats trong Search Console cho thấy phần lớn request đến URL filter/sort
4 nhóm URL nên ưu tiên Disallow
Trong các dự án e-commerce HEROSEO từng triển khai, đây là 4 nhóm ngốn crawl budget nặng nhất:
- URL filter và sort: ?color=red&size=L&sort=price
- URL search nội bộ: ?s=keyword, /search?q=
- URL tracking parameter: ?utm_source=, ?ref=, ?fbclid=
- URL phân trang sâu của taxonomy: /tag/x/page/50/
Phối hợp robots.txt với chiến lược index tổng thể
Robots.txt chỉ là một mắt xích. Để tối ưu crawl budget hiệu quả, cần phối hợp đồng bộ:
- Robots.txt chặn nhóm URL không có giá trị crawl
- Sitemap XML chỉ chứa URL có giá trị index, không liệt kê URL filter
- Internal link tập trung dẫn về URL money, không link tới URL đã chặn
- Canonical xử lý các URL trùng lặp gần giống
Việc tối ưu robots.txt cho website lớn không thể tách rời khỏi chiến lược index và crawl tổng thể. Theo kinh nghiệm triển khai Technical SEO Audit tại HEROSEO, các dự án có nhiều URL filter và tracking parameter thường thấy crawl budget cải thiện rõ rệt sau khi rà soát đồng thời robots.txt, sitemap và canonical — chứ không phải chỉ tinh chỉnh một mắt xích đơn lẻ.
Đây là góc nhìn mà ít blog Việt đề cập, vì nó đòi hỏi kinh nghiệm thực chiến từ các dự án có quy mô và độ phức tạp URL lớn — vùng chuyên môn HEROSEO tích lũy qua nhiều năm triển khai cho doanh nghiệp ở các ngành khác nhau.
File robots.txt là file nhỏ nhưng quyết định cách Googlebot tương tác với toàn bộ website của bạn. Một dòng sai có thể khiến site mất ranking trong vài tuần; một file đúng giúp crawl budget tập trung vào URL có giá trị thương mại. Với website dưới 1.000 URL, đa số doanh nghiệp có thể tự cấu hình theo template trong bài. Với dự án quy mô lớn hoặc đang tụt traffic, robots.txt nên là một phần của Technical SEO Audit độc lập.
Nếu website của bạn đang gặp vấn đề về crawl/index hoặc cần rà soát Technical SEO toàn diện, đội ngũ HEROSEO sẵn sàng đồng hành. Đặt lịch tư vấn 1-1 với chuyên gia Technical SEO HEROSEO để được phân tích tình trạng hiện tại, nhận audit nhanh các điểm rủi ro và đề xuất hướng xử lý theo priority rõ ràng.


Chưa có bình luận nào